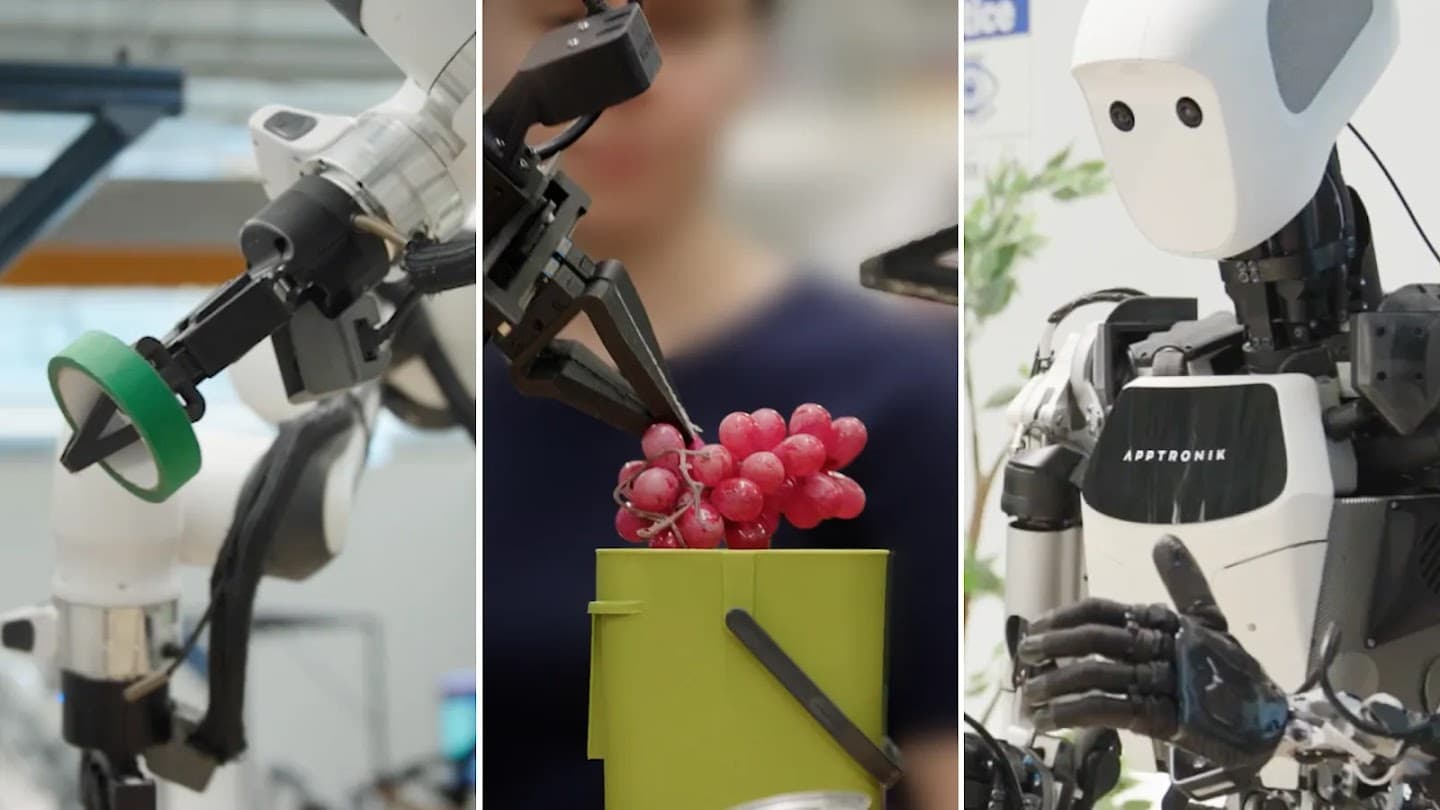
Google DeepMindは、ロボット向けの新モデル群「Gemini Robotics 1.5」と「Gemini Robotics-ER 1.5」を発表した。ロボットが視覚情報を理解し、作業計画を立て、必要に応じてデジタルツールを使いながら物理世界で行動することを狙う。
2つのモデルが役割分担する
Gemini Robotics-ER 1.5は、高レベルの推論と計画を担う身体性推論モデルだ。環境を見て、対象物の位置や状態を理解し、作業の進み具合を推定する。Gemini Robotics 1.5は、視覚と言語からロボットの動作へ変換するVLA(Vision-Language-Action)モデルとして、具体的な動きに落とし込む。
モデル | 主な役割 |
|---|---|
Gemini Robotics-ER 1.5 | 空間理解、計画、ツール呼び出し、進捗推定 |
Gemini Robotics 1.5 | 視覚・言語からロボット動作への変換 |
なぜビジネス読者に重要か
工場、物流、店舗、介護、研究施設では、人手不足と多品種・少量対応が同時に進んでいる。従来のロボットは決められた環境と作業に強かったが、Physical AIは、状況を理解して手順を組み替える方向に進む。これは設備投資だけでなく、現場データ、シミュレーション、運用ルールの設計競争でもある。
導入には安全評価が欠かせない
DeepMindは、安全性評価としてASIMOVベンチマークの更新にも触れている。物理世界で動くAIは、画面上のエージェントより事故の影響が大きい。導入企業は、動作範囲、停止条件、監視責任、現場作業者との役割分担を明確にする必要がある。
参考: Google DeepMind