Microsoft Researchは、モバイルロボットの物体操作ワークロードについて、オンボードGPU、エッジ、クラウドを横断した推論基盤の実測研究を発表しました。結論は単純ではありません。小型GPUでは処理が足りず、大型GPUを載せるとバッテリーや重量に響き、クラウドに丸投げすると遅延と帯域が問題になります。
Physical AIを現場へ入れる企業にとって、この研究は「賢いモデル」だけではなく、「どこで推論を動かすか」がロボット性能を左右することを示しています。
オンボードGPU前提の限界
現在のロボットAIは、ロボット本体にGPUを載せ、推論も本体で行う設計が一般的です。しかし、モデルが大きくなるほど、電力消費、発熱、重量、コストが増えます。Microsoft Researchは、キッチンでゴミを見つけて捨てるようなモバイル操作タスクを例に、意味地図、計画、ナビゲーション、操作を分解して測定しました。
研究では、小型オンボードGPUではワークロード全体を載せられない場合があり、十分なメモリを持つGPUでもA100と比べて地図作成や計画が最大383%遅くなるケースがあると説明されています。
方式 | 利点 | 注意点 |
|---|---|---|
オンボード推論 | 通信断に強く低遅延 | 電力、重量、モデルサイズに制約 |
エッジ推論 | 高性能GPUを共有しやすい | 現場ネットワーク設計が必要 |
クラウド推論 | 大規模モデルを使いやすい | 遅延、帯域、データ管理が課題 |
ロボットフリートでは共有計算資源が鍵になる
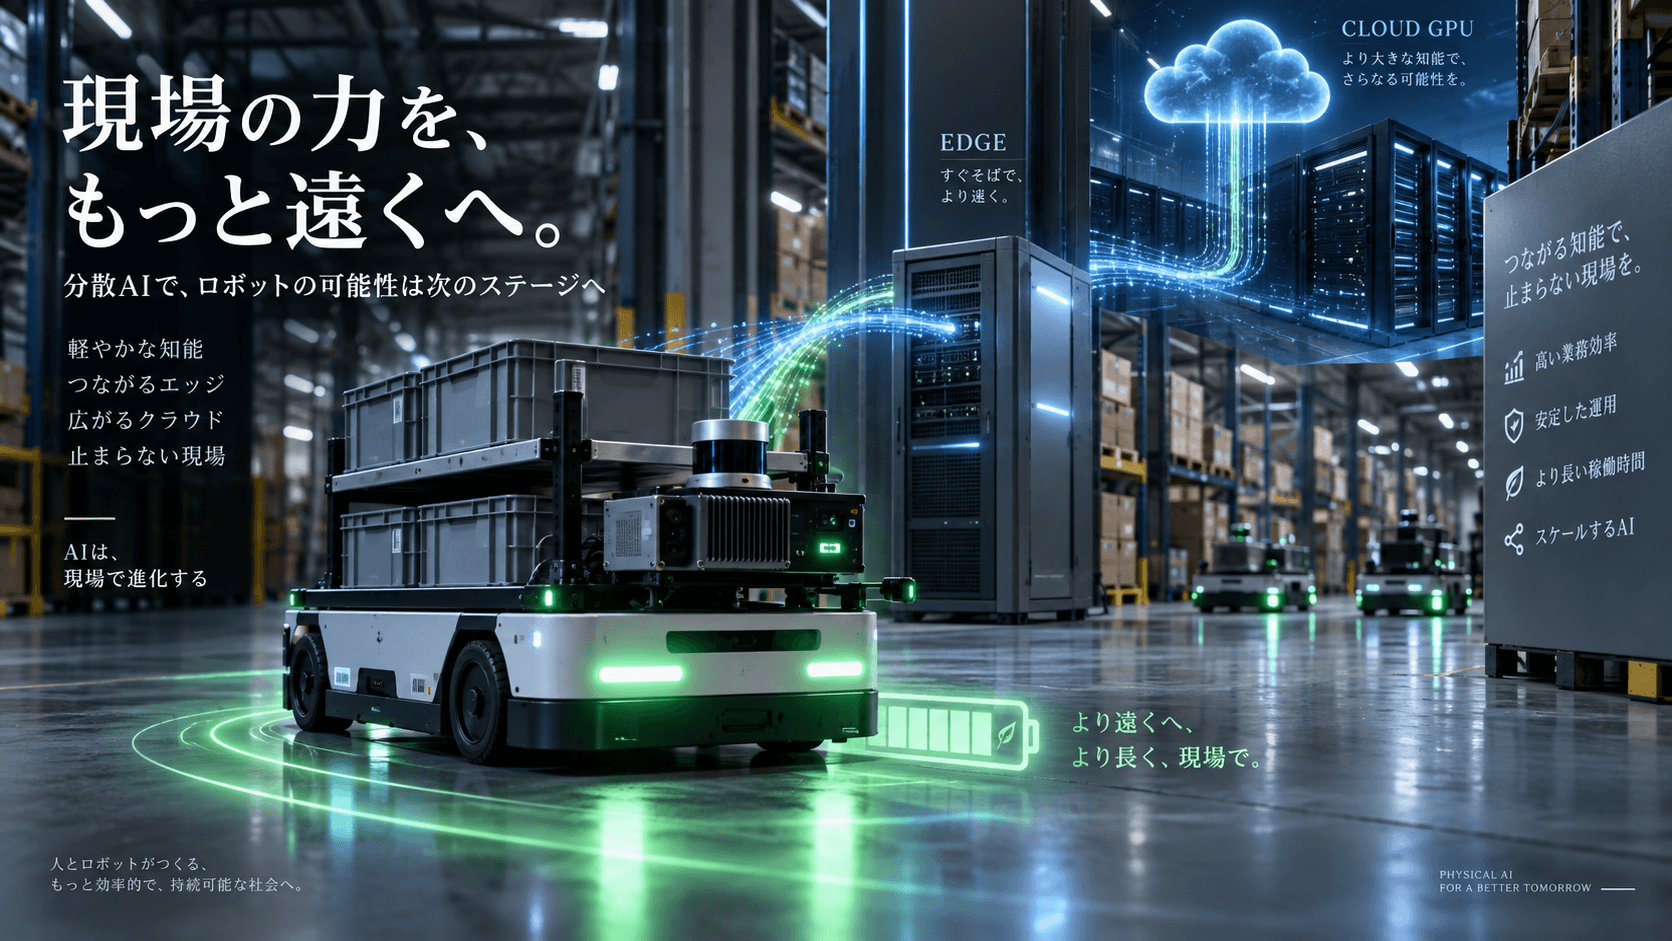
工場や倉庫では、1台のロボットだけでなく複数台のフリートが稼働します。すべてに高性能GPUを積むより、現場側のエッジGPUを共有し、必要なタイミングで推論を割り当てる方が、コストとバッテリーの両面で有利になる可能性があります。
Microsoftは、Physical AI Toolchainの一部として、Kubernetesベースのツールでロボット、エッジ、クラウドにまたがるAIワークロードをコンテナ化・展開・オーケストレーションする方向も示しています。
日本企業が検討すべき実装論点
製造、物流、介護、警備などでロボット導入を考える企業は、ロボット本体の性能比較だけでなく、現場ネットワーク、エッジサーバー、MLOps、障害時の縮退運転をセットで設計する必要があります。
特に、遅延が安全性に直結する操作は本体または近距離エッジに残し、重い地図更新や計画、学習はエッジ/クラウドへ分散する設計が現実的です。Physical AIの競争力は、モデル単体ではなく、現場に合った推論配置を作れるかで決まります。